Loading...
Searching...
No Matches
uninews.fetchers.html.HtmlFetcher Class Reference
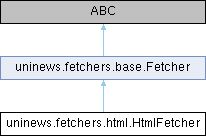
Inheritance diagram for uninews.fetchers.html.HtmlFetcher:
Public Member Functions | |
| __init__ (self, str publisher, str category, dict config) | |
| list[dict] | fetch_raw (self) |
| str | explain_empty_page (self, str html) |
| Iterator[str] | page_urls (self) |
| list[dict] | parse_page (self, str html) |
| dict|None | parse_item (self, Tag item) |
| Tag|None | find_link (self, Tag item) |
| bool | is_article_link (self, Tag link) |
| str | select_text (self, Tag item, str key) |
| str | find_image (self, Tag item) |
| str | strip_noise (self, str text) |
 Public Member Functions inherited from uninews.fetchers.base.Fetcher | |
| __init_subclass__ (cls, **kwargs) | |
| str | __repr__ (self) |
| list[Article] | fetch (self) |
| requests.Response | request (self, str url) |
| str | get_html (self, str url) |
Public Attributes | |
| pages | |
| Public Attributes inherited from uninews.fetchers.base.Fetcher | |
| publisher | |
| category | |
| config | |
Static Public Attributes | |
| str | fetcher_type = "html" |
| required_keys = Fetcher.required_keys + ("item_selector", "title_selector") | |
| tuple | noise_phrases |
| Static Public Attributes inherited from uninews.fetchers.base.Fetcher | |
| ClassVar | fetcher_type = "" |
| tuple | required_keys = ("label", "url") |
| dict | registry = {} |
Detailed Description
JSON keys:

required: label, url, item_selector, title_selector
optional: date_selector, summary_selector, image_selector (default "img"),
          pages (default 1), page_url (needed when pages > 1,
          e.g. "{url}?pn={page}" or "{url}/page/{page}/")

Comma-separated title/date/summary/image selectors are tried left to right:
the first one that matches wins. (Plain CSS would pick whichever element
comes first in the page instead.)
Constructor & Destructor Documentation
◆ __init__()
| uninews.fetchers.html.HtmlFetcher.__init__ | ( | self, | |
| str | publisher, | ||
| str | category, | ||
| dict | config | ||
| ) |
Reimplemented from uninews.fetchers.base.Fetcher.
Member Function Documentation
◆ explain_empty_page()
| str uninews.fetchers.html.HtmlFetcher.explain_empty_page | ( | self, | |
| str | html | ||
| ) |
◆ fetch_raw()
| list[dict] uninews.fetchers.html.HtmlFetcher.fetch_raw | ( | self | ) |
Return dicts with 'title' and 'link'.

Optional keys: 'published', 'summary', 'image_url'.
Links and image URLs may be relative.
Reimplemented from uninews.fetchers.base.Fetcher.
◆ find_image()
| str uninews.fetchers.html.HtmlFetcher.find_image | ( | self, | |
| Tag | item | ||
| ) |
◆ find_link()
| Tag | None uninews.fetchers.html.HtmlFetcher.find_link | ( | self, | |
| Tag | item | ||
| ) |
◆ is_article_link()
| bool uninews.fetchers.html.HtmlFetcher.is_article_link | ( | self, | |
| Tag | link | ||
| ) |
◆ page_urls()
| Iterator[str] uninews.fetchers.html.HtmlFetcher.page_urls | ( | self | ) |
◆ parse_item()
| dict | None uninews.fetchers.html.HtmlFetcher.parse_item | ( | self, | |
| Tag | item | ||
| ) |
◆ parse_page()
| list[dict] uninews.fetchers.html.HtmlFetcher.parse_page | ( | self, | |
| str | html | ||
| ) |
◆ select_text()
| str uninews.fetchers.html.HtmlFetcher.select_text | ( | self, | |
| Tag | item, | ||
| str | key | ||
| ) |
◆ strip_noise()
| str uninews.fetchers.html.HtmlFetcher.strip_noise | ( | self, | |
| str | text | ||
| ) |
Member Data Documentation
◆ fetcher_type
|
static |
◆ noise_phrases
|
static |
Initial value:
= (
"Continue reading →",
"Read more",
"Συνεχίστε την ανάγνωση →",
"Περισσότερα",
)
◆ pages
| uninews.fetchers.html.HtmlFetcher.pages |
◆ required_keys
|
static |
The documentation for this class was generated from the following file:
- src/uninews/fetchers/html.py